


Qlik Replicate та Open Lakehouse: можливості й економія
 1
Для компаній, які вже використовують Qlik Replicate, розвиток аналітики та проєктів штучного інтелекту ставить практичне питання: як підготувати дані для нових завдань, зберігаючи налаштовані процеси реплікації та інвестиції в них?
Нова функція Replicate Source for Open Lakehouse у Qlik Talend Cloud дозволяє доставляти дані з наявних інсталяцій Qlik Replicate до таблиць Apache Iceberg через Qlik Open Lakehouse. Це не потребує оновлення Replicate, міграції наявних потоків або впровадження додаткового шару завантаження даних.
Як працює інтеграція з Open Lakehouse
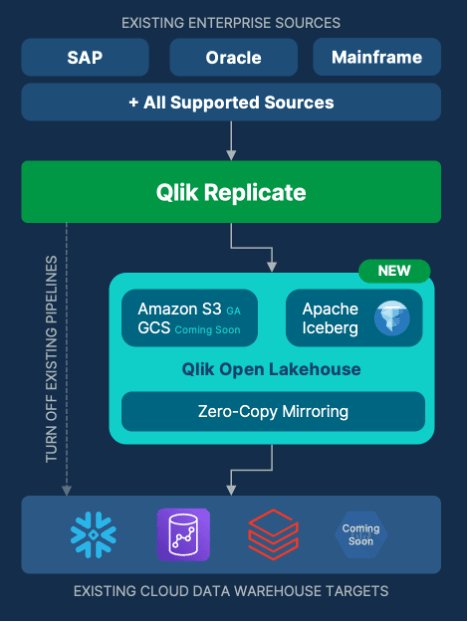
Точкою підключення є хмарне об’єктне сховище, до якого Qlik Replicate записує дані з корпоративних джерел. Подальшу обробку виконує Qlik Open Lakehouse:
- Qlik Replicate передає дані до об’єктного сховища. Джерелами можуть бути мейнфрейми, SAP і традиційні реляційні бази даних.
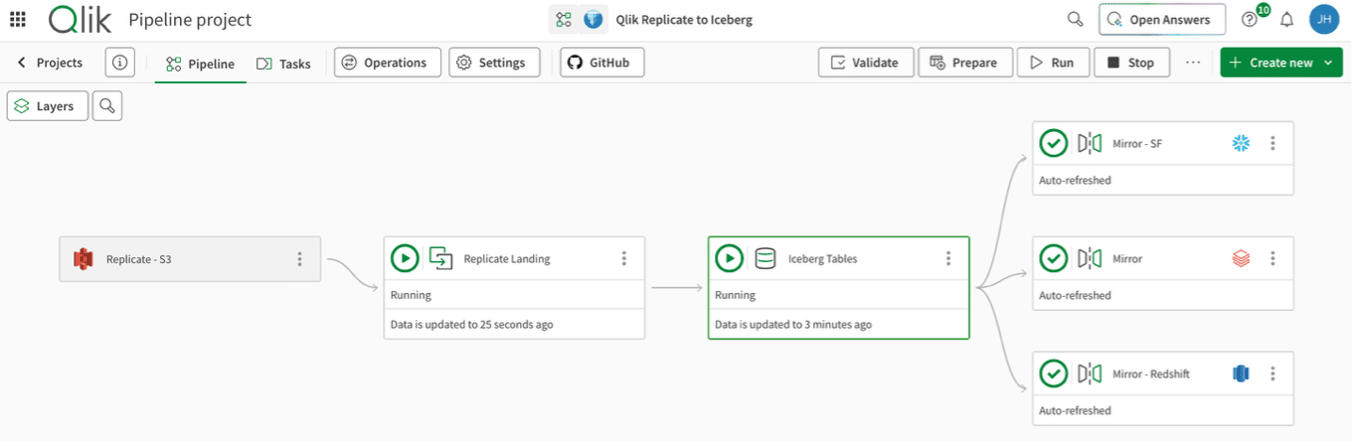
- Завдання типу Replicate landing зчитує результат реплікації. Воно безпосередньо розпізнає вихідні дані Replicate.
- Open Lakehouse безперервно записує та оптимізує таблиці Apache Iceberg. Після налаштування цей процес працює автоматично.
Обробка даних більше не завершується на файлах CSV або Parquet в об’єктному сховищі: вони надходять до керованого Iceberg lakehouse. Для компаній зі складним набором джерел це означає, що наявні підключення до критично важливих систем можна використовувати для наповнення нового аналітичного середовища.
Що Apache Iceberg дає бізнесу
Apache Iceberg — відкритий табличний формат, який підтримують Snowflake, Databricks, Amazon Redshift, Google BigQuery та інші сучасні системи обробки даних. Він дозволяє звертатися до тих самих таблиць із різних платформ без копіювання даних. Компанія може обирати інструменти під конкретні завдання — звітність, прогнозування або машинне навчання — та зменшувати залежність від одного постачальника.
Окрім сумісності, Iceberg забезпечує:
- ACID-транзакції — підтримку цілісності та узгодженості даних під час запису й оновлення.
- Еволюцію схеми — можливість змінювати структуру таблиць відповідно до нових вимог.
- Time travel — доступ до попередніх станів таблиць для дослідження змін і відтворення результатів аналізу на певний момент.
Ці можливості допомагають адаптувати аналітичне середовище до змін у бізнесі та перевіряти, на яких даних ґрунтувалися попередні результати. Відкритий формат також створює основу для AI-проєктів; якість і придатність даних для конкретного застосування потребують окремого контролю.
Завдяки чому скорочуються витрати
Потенційна економія в Qlik Open Lakehouse формується на трьох рівнях.
Автоматизація технічного обслуговування. Adaptive Optimizer автоматично ущільнює файли, оптимізує їхні розміри та керує файлами, які більше не пов’язані з таблицями. Це скорочує обсяг ручних операцій для інженерів і звільняє час для розвитку аналітичних рішень.
Доступ до даних через zero-copy mirroring. Таблиці Iceberg можна зробити доступними у Snowflake, Databricks, Google BigQuery або Amazon Redshift без плати за завантаження даних до хмарного Data Warehouse. Для компаній із прямими потоками Replicate–Data Warehouse це може зменшити відповідні витрати зі зростанням обсягів. Йдеться саме про завантаження: зберігання даних і виконання аналітичних запитів мають власну вартість.
Модель обчислень та оплати. Завантаження й оптимізація даних у форматі Iceberg виконуються на кластерах із використанням дешевших spot instances у віртуальній приватній хмарі клієнта — VPC. Оплата розраховується за години використання обчислювальних ядер (compute core-hours), а не за обсяг даних. Така модель може бути вигідною для частого передавання змін за допомогою Change Data Capture (CDC).
За даними дослідження Nucleus Research, наведеного Qlik, клієнти, які перенесли операції завантаження з обчислювальних ресурсів Data Warehouse до Qlik Open Lakehouse, скоротили відповідні обчислювальні витрати до 70%. Цей показник не стосується загальної вартості інфраструктури. Результат для конкретної компанії залежить від її навантаження та конфігурації.
Як оцінити доцільність для своєї компанії
Варто порівняти витрати на поточну схему доставки даних із моделлю Open Lakehouse, врахувавши частоту й обсяг змін CDC, обчислювальні ресурси для завантаження, час команди на обслуговування та платформи, які використовуватимуть таблиці Iceberg.
Насамперед доцільно розглянути потоки, де дані з одних джерел потрібні кільком аналітичним системам або витрати на завантаження до Data Warehouse зростають. Таке порівняння допоможе визначити пріоритетні підключення та оцінити очікувану економію.
Більше про можливості реплікації та доставки даних із корпоративних систем — на сторінці Qlik Replicate.
 1
Як використовувати дані з Qlik Replicate у відкритій архітектурі Apache Iceberg без перебудови наявних потоків. Можливості Open Lakehouse та економія на роботі з даними.
 21
Як перетворити 240 індикаторів на зручну аналітику? Ділимося досвідом інтеграції державних даних та створення інтерактивного рішення на Qlik Sense для Європейського індексу міст.


